
Как попасть в ответы нейросетей: пошаговый план и разбор по платформам
Чтобы нейросеть называла ваш бренд, нужно сделать три вещи: открыть сайт для AI-краулеров, переписать ключевые страницы так, чтобы из них можно было вырезать готовый ответ, и добиться упоминаний за пределами собственного сайта. Порядок именно такой — контент бесполезен, если краулер до него не дошёл, а внешние упоминания не помогут, если на сайте нечего цитировать.
Ниже — что конкретно делать на каждом шаге и чем отличаются пять поверхностей, в которых стоит присутствовать российскому бизнесу. Механику самих генеративных движков разбираем отдельно, в материале о том, что такое GEO-продвижение.
Где нужно присутствовать: пять поверхностей, пять разных механик
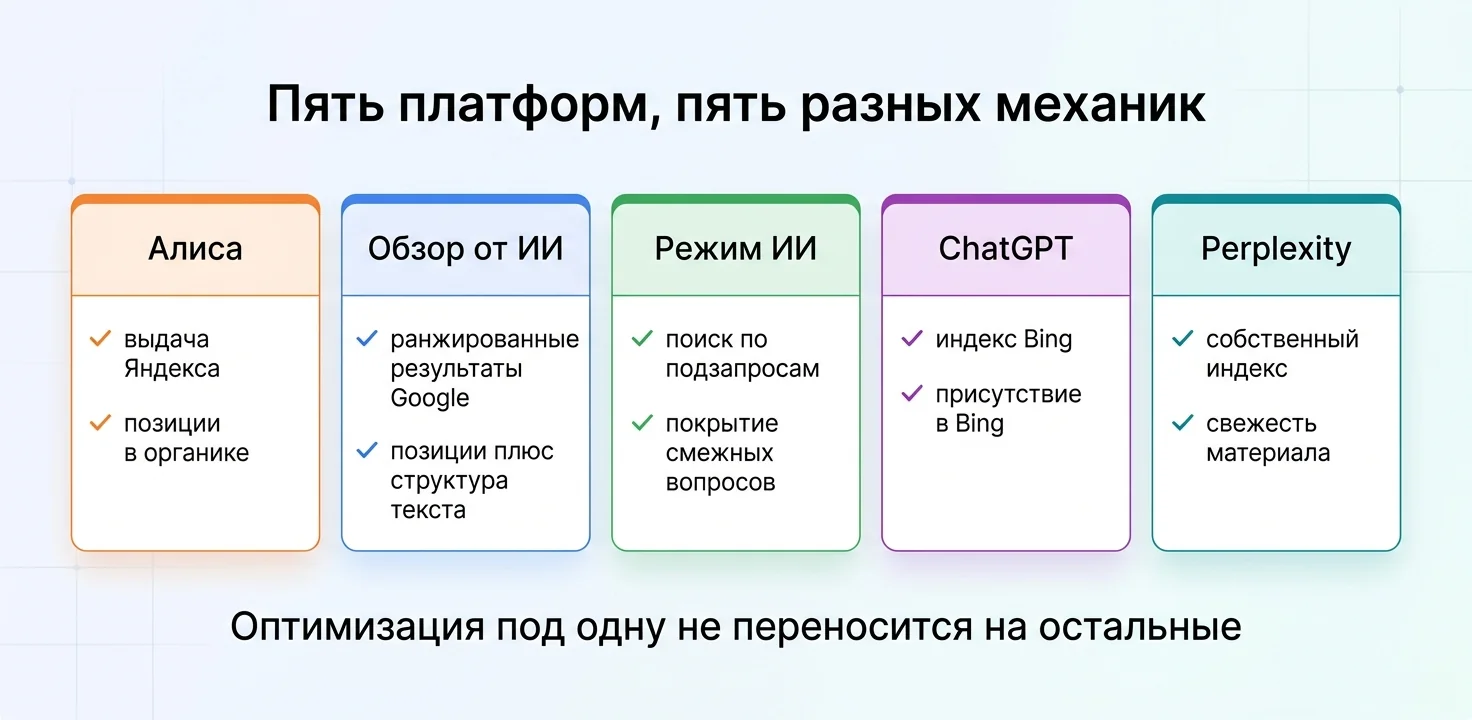
Единой «оптимизации под нейросети» нет: платформы используют разные индексы и по-разному отбирают материалы.
Общая ошибка — считать, что «нейросети» это одно. У пяти систем разные источники и разная логика отбора, и оптимизация под одну не переносится на другую автоматически.
Две из них — поверхности Google, и путать их не стоит: Обзор от ИИ синтезирует ответ из результатов, которые Google уже отранжировал, а Режим ИИ разбивает вопрос на подзапросы и ищет по каждому отдельно. В мае 2026 Google объявил о сведении их в единый AI-поиск, но пока это разные механизмы отбора.
Разбираем по очереди, начиная с той, что для российского рынка важнее всего.
Алиса и нейроответы Яндекса: вход только через органику
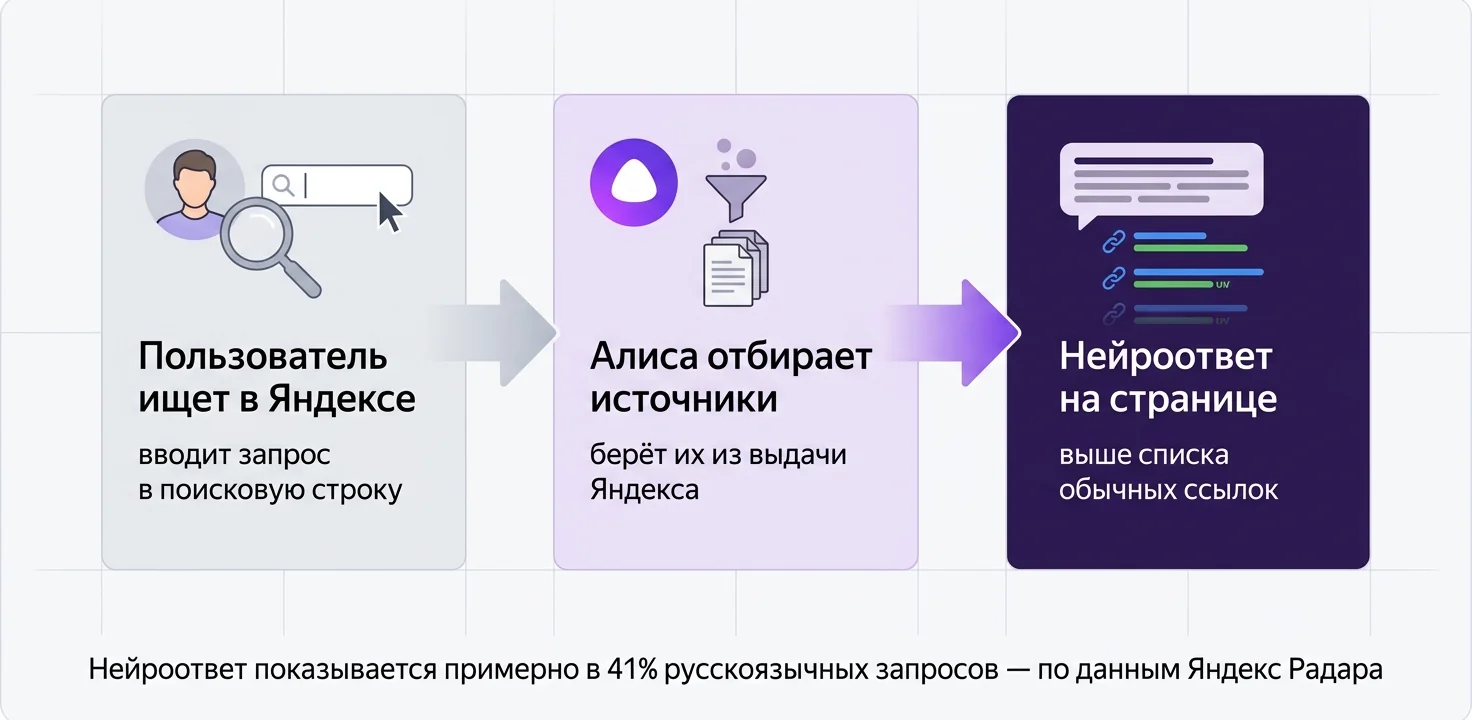
Для Алисы поисковая доступность — первый фильтр: только после него материал может стать источником нейроответа.
Ключевое отличие Яндекса: поисковые алгоритмы сначала подбирают подходящие материалы в интернете, затем нейросети анализируют их и собирают ответ со ссылками. Поэтому классическое SEO остаётся фундаментом, но хорошая позиция сама по себе не гарантирует цитирование — публичного порога вроде обязательного топ-10 или топ-30 Яндекс не указывает.
Страница должна быть доступна роботу, отвечать на формулировку запроса и содержать самодостаточные фрагменты с проверяемыми фактами. Проверять результат можно в отчёте «Видимость сайта в Алисе AI» Яндекс Вебмастера и на одинаковой панели безбрендовых запросов.
Технический чек-лист, требования к тексту, роль внешних источников и методику замера подробно разбираем в отдельном материале: продвижение в нейроответах Яндекса и Алисы.
ChatGPT: всё упирается в Bing
Самая недооценённая деталь: поиск ChatGPT опирается на индекс Bing. Если сайта нет в Bing, ChatGPT его не найдёт — независимо от того, как хорошо он ранжируется в Google.
Российские компании массово это игнорируют. Bing Webmaster Tools не настроен, sitemap туда не отправлен, ошибки сканирования не разбирались. При этом кабинет бесплатный, подтверждение домена делается импортом из Google Search Console за пару кликов, а это единственный бесплатный источник данных о том, как часто вас цитируют в ответах Copilot.
Второй фактор — скорость. У ретривала есть бюджет времени на ответ, и медленную страницу он просто не дожидается. Разница между сайтом, который отдаёт контент за доли секунды, и сайтом, который думает больше секунды, измерима в числе цитирований.
Третий — рендеринг. Большинство retrieval-агентов, в отличие от Googlebot, JavaScript не выполняют вообще. Если контент появляется только после выполнения скриптов, для ChatGPT ваша страница пустая. Не «плохо оптимизированная» — пустая.
Обзор от ИИ: здесь классическое SEO ещё работает
Обзор от ИИ — блок над обычной выдачей Google. По заявлению Сундара Пичаи на I/O в мае 2026, аудитория превысила 2,5 млрд пользователей в месяц.
Механика: система синтезирует ответ из результатов, которые Google уже отранжировал. Значит хорошие позиции повышают шанс попасть в цитаты — но гарантии больше не дают.
Ещё в июле 2025 Ahrefs находил, что 76% процитированных страниц были в органическом топ-10. К началу 2026 эта доля упала до 17–38% по двум разным исследованиям. То есть две трети источников приходят со страниц, которых пользователь на первой странице выдачи не увидел бы.
Что это значит практически: позиции остаются полезными, но недостаточными. К ним добавляется требование к структуре — цитируется не страница, а фрагмент, и он должен быть готовым ответом.
Отдельно стоит знать про E-E-A-T: опыт, экспертиза, авторитетность, доверие. Для Google это не отдельный фактор, а описание цели, к которой алгоритм приближается косвенными признаками. Наблюдаемые признаки — реальный автор с внешним следом, ссылки на первоисточники, прозрачная информация об организации.
Режим ИИ: где привычное SEO почти не помогает
Режим ИИ — отдельная диалоговая вкладка Google, где органических ссылок рядом нет вовсе. К маю 2026 аудитория превысила миллиард пользователей в месяц.
Механика принципиально другая — query fan-out. Система не обрабатывает вопрос как одну строку: она разбивает его на подзапросы, выполняет до шестнадцати поисков одновременно и синтезирует ответ из объединённых результатов.
Отсюда цифры, которые стоит знать перед тем, как вкладываться:
- пересечение процитированных URL с органическим топ-10 — около 14%
- при трёх повторах одного и того же запроса совпадает лишь 9,2% ссылок
- Режим ИИ и Обзор от ИИ цитируют одни и те же URL в 13,7% случаев, хотя приходят к схожим выводам в 86% — это на выборке 540 000 пар запросов
- в среднем ответ ссылается примерно на 7 уникальных доменов
Практический вывод: под Режим ИИ бесполезно оптимизировать одну страницу под один запрос. Выигрывает тот, чей материал закрывает веер связанных подвопросов вокруг темы. Не одна статья на пять тысяч слов, а связная система материалов с ясными смысловыми блоками.
Perplexity: свежесть решает больше, чем авторитет
Perplexity устроена самостоятельнее остальных: собственный краулер, собственный индекс, живой поиск на каждый запрос без опоры на «память» модели.
Главная особенность — наивысший вес свежести среди всех движков. Материал, обновлённый на прошлой неделе, обходит прошлогодний по тому же вопросу, даже если второй авторитетнее.
Второе — опора на обсуждения. Perplexity заметно чаще остальных цитирует форумы и сообщества, где люди сравнивают продукты и делятся опытом. Для русскоязычного рынка это VC, Хабр, профильные телеграм-каналы и отзовики.
Третье — доступ. Бот PerplexityBot индексирует, Perplexity-User загружает страницу по запросу пользователя. Оба должны быть открыты в robots.txt.
Технический минимум: что сделать до работы над текстом
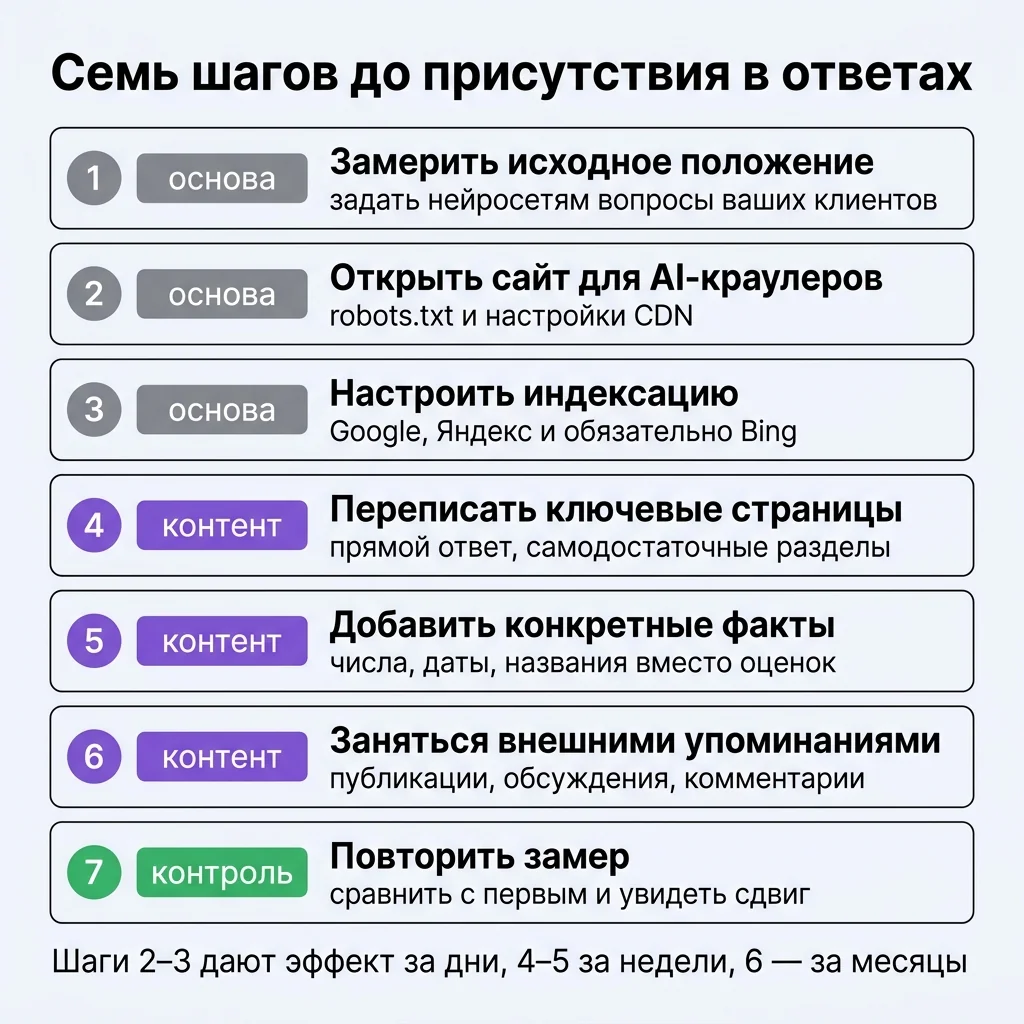
Порядок важен: сначала доступ и индексация, затем контент и внешние упоминания, после — контрольный замер.
Шаг 1. Откройте сайт для AI-краулеров. Проверьте robots.txt на GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, Perplexity-User, ClaudeBot, Claude-User. Отдельно проверьте настройки CDN: он может резать ботов выше уровня robots.txt, и в логах сервера этого не будет видно.
Шаг 2. Убедитесь, что контент есть в исходном HTML. Откройте страницу, нажмите просмотр исходного кода и поищите свой текст. Если его там нет — он появляется только через JavaScript, и для большинства retrieval-агентов страница пустая. Лечится серверным рендерингом или генерацией статики.
Шаг 3. Настройте индексацию в Bing. Подтвердите домен в Bing Webmaster Tools, отправьте sitemap, разберите ошибки сканирования — они часто отличаются от гугловских. Это шлюз для ChatGPT.
Контент и внешний след: что делать дальше
Шаг 4. Перепишите ключевые страницы под извлечение. Прямой ответ в первых ста словах. Подзаголовок должен нести смысл сам по себе: «Особенности» — мёртвый заголовок, «Сколько времени занимает внедрение» — рабочий. Раздел должен читаться без предыдущих: местоимения раскрыты, отсылок «как мы писали выше» нет.
Шаг 5. Добавьте фактическую плотность. Числа, даты, диапазоны, названия. Сравните: «внедрение занимает некоторое время» — вставить в ответ нечего; «внедрение занимает 3–6 недель для команды до 20 человек» — готовая цитата. То же с оценками: не «мы лидеры рынка», а «12 000 заявок со средним сроком ответа два часа».
Шаг 6. Займитесь внешними упоминаниями. Языковые модели извлекают информацию из текста, а не из графа ссылок. Упоминание бренда в обзоре без гиперссылки для классического SEO значит немного — для генеративной системы это ровно тот материал, из которого складывается представление о вас. Работают отраслевые публикации, экспертные комментарии, присутствие в обсуждениях.
Шаг 7. Добейтесь попадания в чужие подборки. Когда пользователь спрашивает «какой сервис выбрать», система идёт в статьи формата «лучшие X» и «X против Y». Ваш собственный сайт для такого вопроса — заведомо предвзятый источник.
Как проверить себя без инструментов
Самый дешёвый способ понять положение дел — задать нейросетям вопросы, которые задаёт ваш клиент, и посмотреть, кого они называют. Десяти вопросов достаточно, чтобы увидеть картину.
Формулируйте как пользователь, а не как владелец бизнеса: не «расскажи про компанию N», а «какой сервис выбрать для такой-то задачи». Прямой вопрос о бренде почти всегда даёт упоминание — он ничего не измеряет.
Проверить техническую сторону тоже можно вручную. Оператор site: в Google и Яндексе покажет, сколько страниц в индексе. Яндекс Вебмастер — попадаете ли вы в источники ответов Алисы. Bing Webmaster Tools — как часто вас цитируют в ответах Copilot.
Что делать с результатами и как считать это системно — разобрано в материале о мониторинге упоминаний бренда.
Типичные ошибки
Оптимизировать под одну нейросеть. У пяти поверхностей разные источники: Алиса берёт из органики Яндекса, ChatGPT — из Bing, Обзор от ИИ — из ранжированной выдачи Google, Режим ИИ — из веера подзапросов. Работа под одну не переносится на остальные.
Считать, что достаточно позиций. Для Яндекса позиции обязательны, для Обзора от ИИ полезны, для Режима ИИ почти не помогают — там пересечение с топ-10 около 14%.
Ждать быстрого результата от внешних упоминаний. Технические правки отражаются в ответах за дни, потому что retrieval работает вживую. Репутация в вебе набирается месяцами.
Проверить один раз и успокоиться. Ответы генеративных систем недетерминированы: один и тот же вопрос в разные дни даёт разные результаты. Единичный замер — это шум, а не измерение.
Писать «под нейросети» вместо людей. Скрытые инструкции в тексте, перенасыщение ключами, шаблонные страницы пачками — всё это детектируется и относится к манипуляции результатами.
Как отслеживать результат
Позиций в генеративном поиске нет — есть частота присутствия. Измеряют по панели реальных вопросов аудитории: по какой доле из них бренд называют, какую долю занимает среди конкурентов, ссылаются ли на сайт.
Glasarity прогоняет ваши запросы по Алисе, Обзору от ИИ, Режиму ИИ, ChatGPT и Perplexity и показывает результат по каждой сети отдельно. Проверить свой бренд
FAQ
С какой нейросети начинать российскому бизнесу? С Алисы, если аудитория русскоязычная и массовая: нейроответ показывается заметной доле пользователей Яндекса. С ChatGPT — если аудитория B2B или технологическая. Начинать стоит с одной, но техническая база из шагов 1–3 общая для всех.
Нужен ли отдельный сайт или раздел под нейросети? Нет. Google прямо говорит, что отдельного индекса для AI-поиска не существует — тот же обход, тот же индекс, те же системы ранжирования. Задача не в том, чтобы сделать второй сайт для роботов, а в том, чтобы один сайт был доступен и пригоден для цитирования.
Влияют ли отзывы на упоминаемость? Влияют, но не сами по себе. Работает не рейтинг, а наличие текстов, где ваш продукт сравнивают с другими и объясняют выбор — именно оттуда система берёт формулировки для ответа.
Помогает ли реклама попасть в ответы? Рекламных форматов внутри генеративных ответов сейчас нет. Косвенно реклама работает через узнаваемость: чем больше о бренде пишут, тем больше материала, из которого система строит ответ.
Итог
Работа делится на три слоя, и они дают результат с разной скоростью. Технический — доступ краулеров, контент в исходном HTML, индексация в Bing — отражается в ответах за дни. Контентный — структура под извлечение и фактическая плотность — за недели. Репутационный — упоминания и присутствие в чужих обзорах — за месяцы.
Начинать логично с первого: пока краулер не дошёл до страницы, всё остальное не имеет значения. И до начала работ стоит снять исходное положение, иначе будет непонятно, что именно сработало.